 IEEE/ICACT20250223 Slide.04
[Big Slide]
Oral Presentation
| Virual Oral Presentation Slide by Slide |
|
IEEE/ICACT20250223 Slide.04
[Big Slide]
| Oral Presentation |
|
|
|
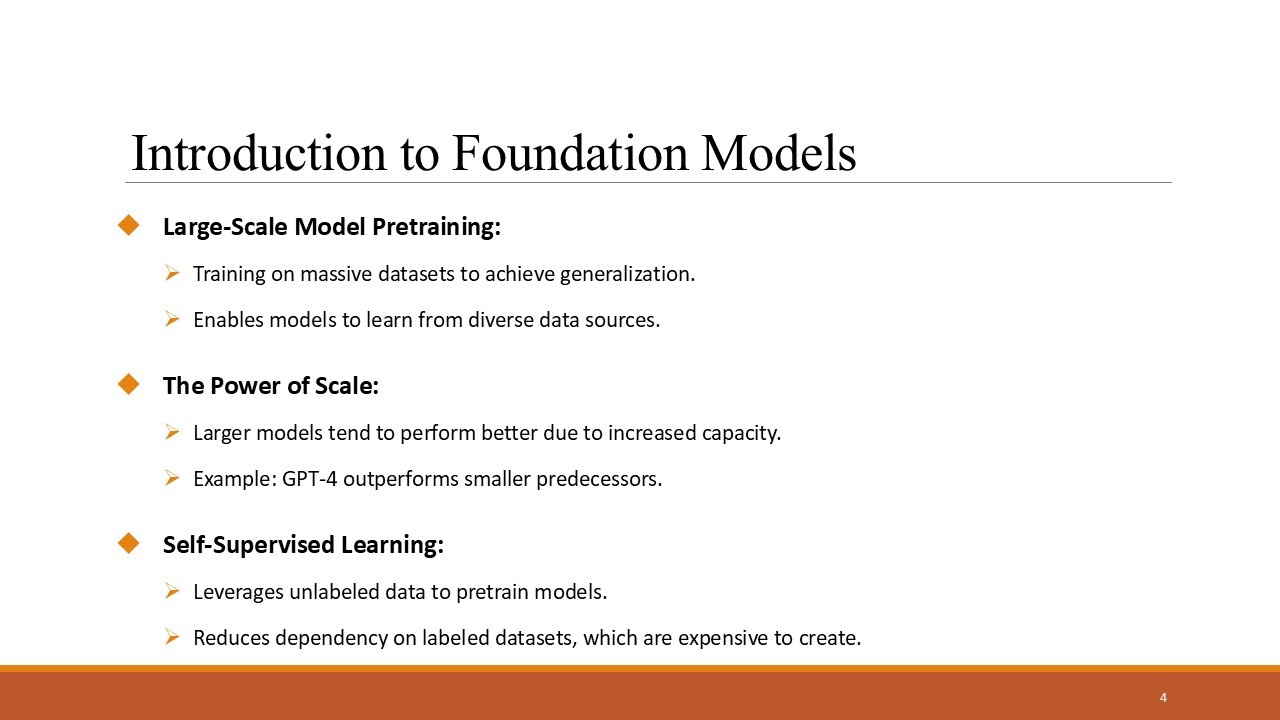
Introduction to Foundation Models Large-Scale Model Pretraining: Training on massive datasets to achieve generalization. Enables models to learn from diverse data sources. The Power of Scale: Larger models tend to perform better due to increased capacity. Example: GPT-4 outperforms smaller predecessors. Self-Supervised Learning: Leverages unlabeled data to pretrain models. Reduces dependency on labeled datasets, which are expensive to create. | |
| [Go to Next Slide] |